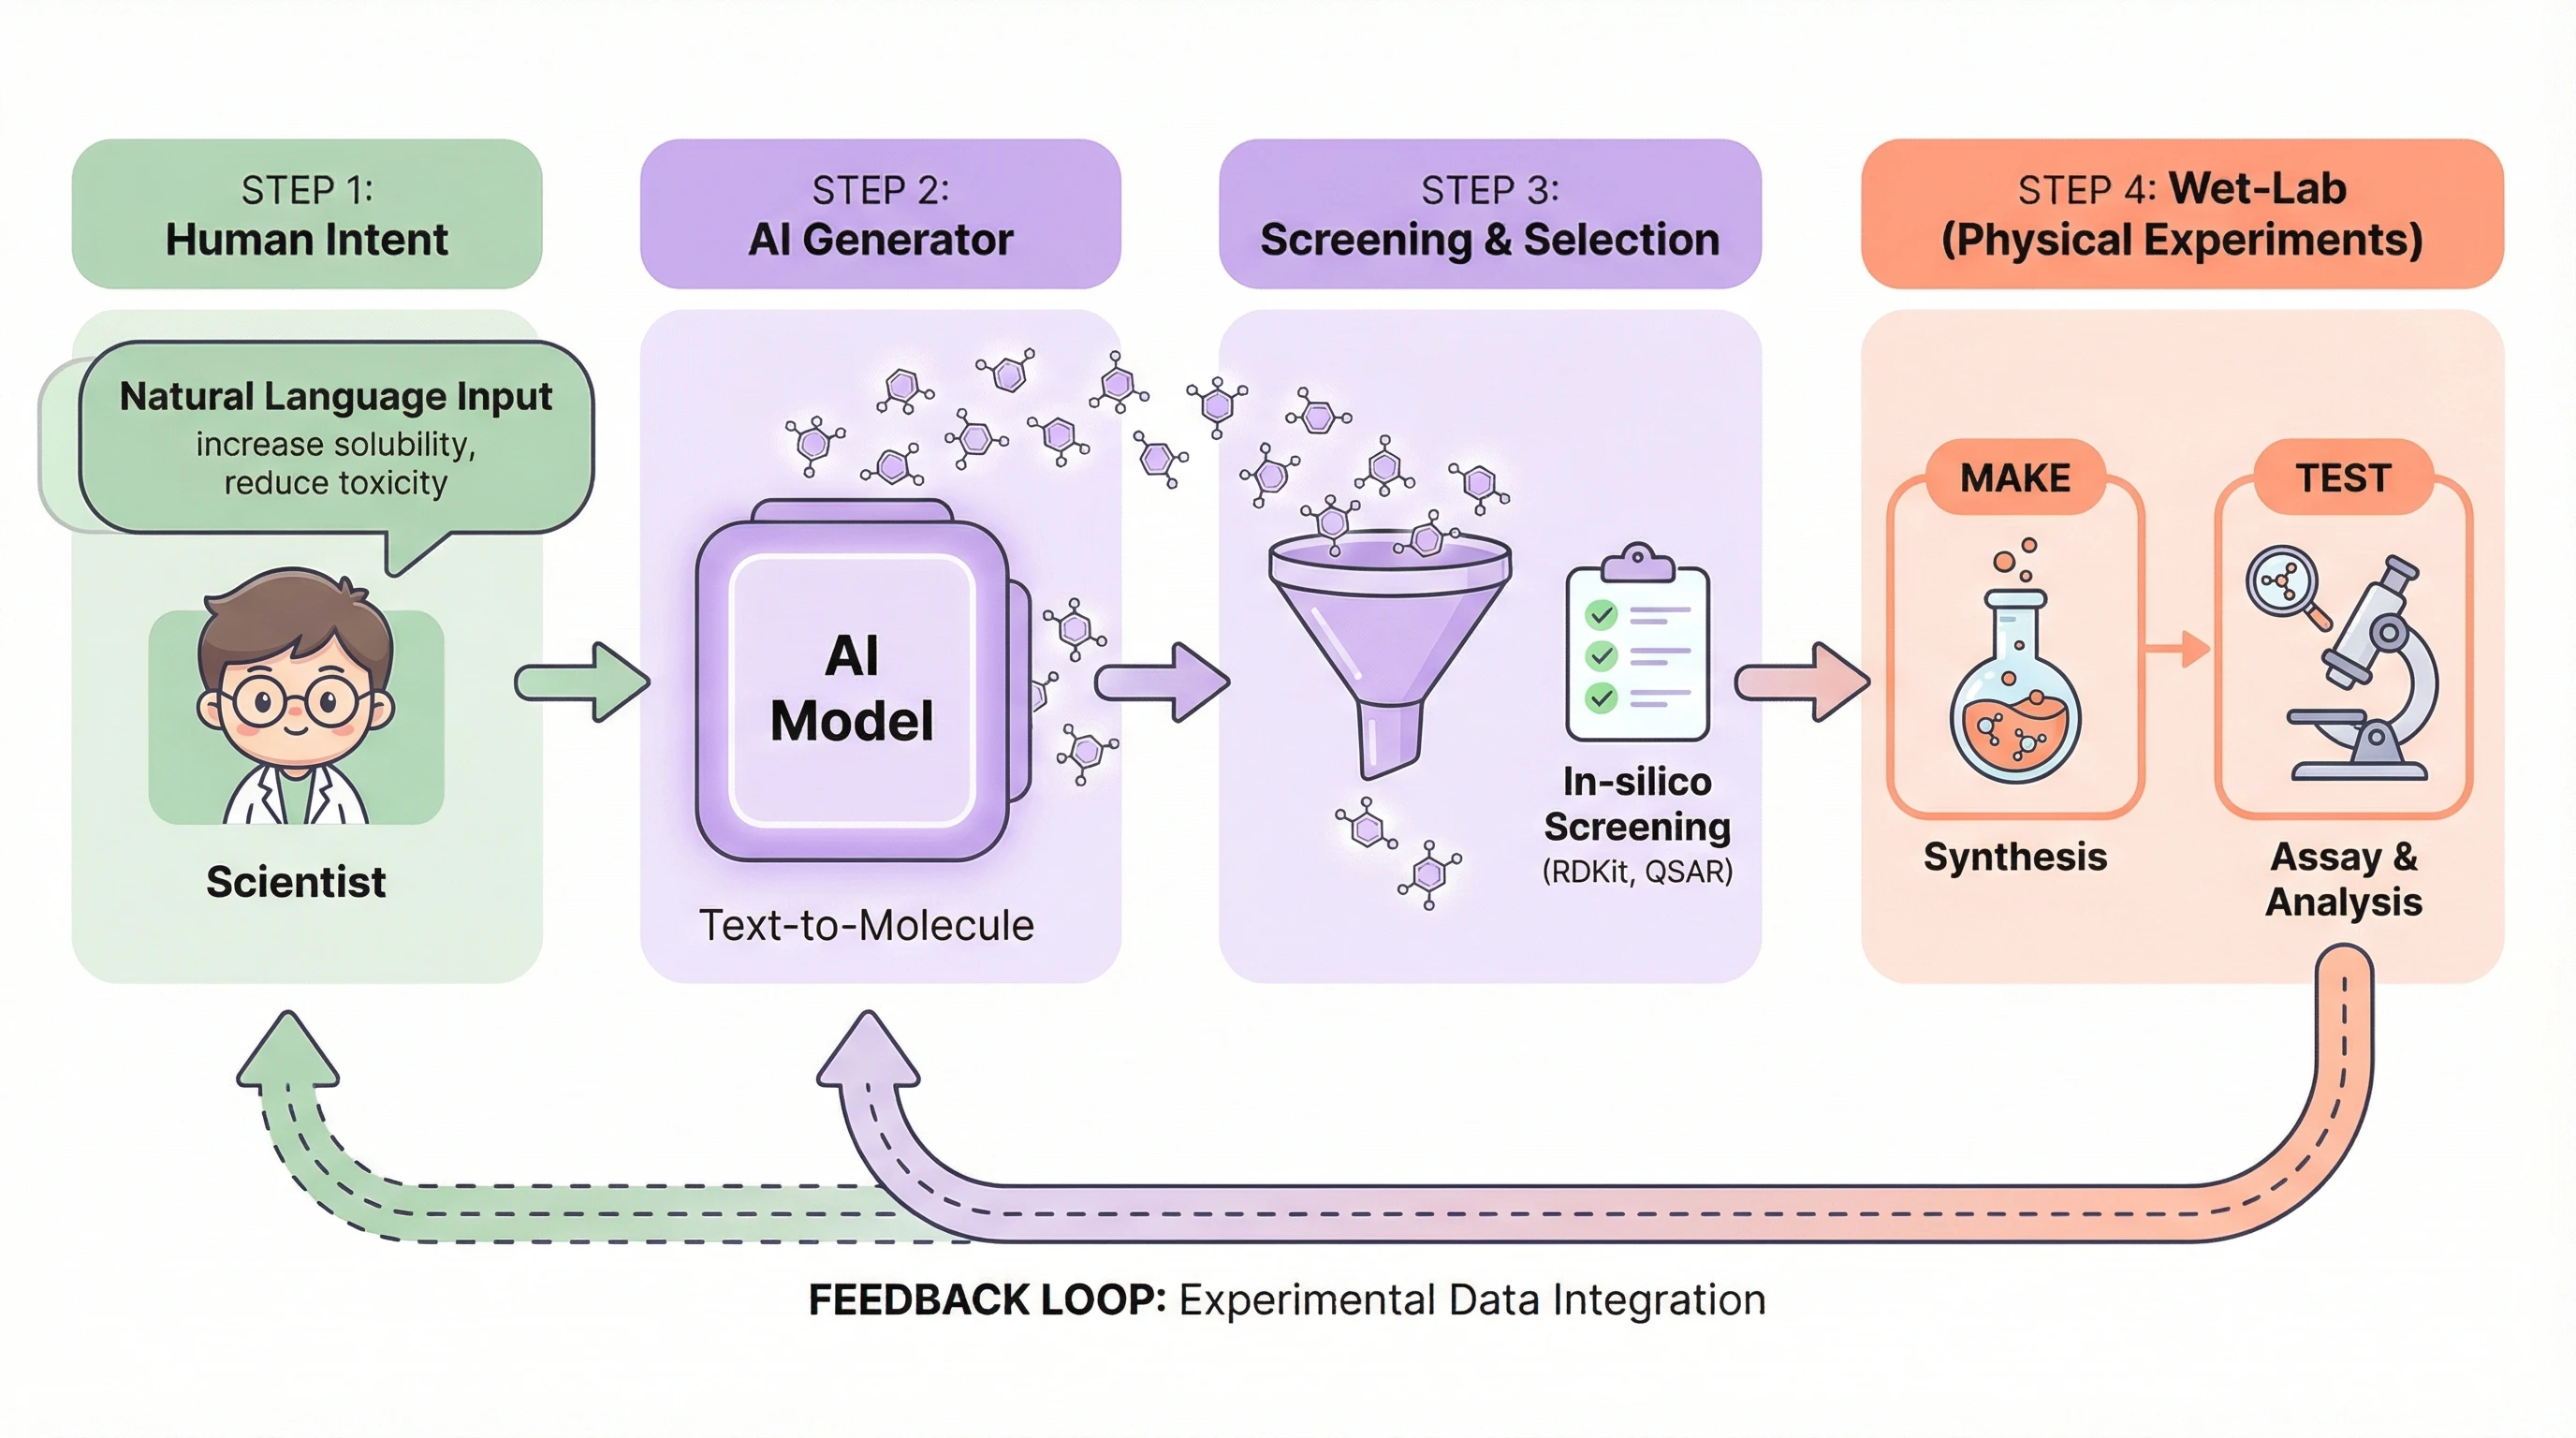
LexiChem bắt đầu từ mô tả phân tử bằng ngôn ngữ tự nhiên, sinh các cấu trúc ứng viên rồi kiểm tra qua RDKit để khảo sát ở dạng 2D/3D. Tôi xây dựng pipeline dữ liệu, chạy thực nghiệm mô hình và đưa suy luận vào sản phẩm.
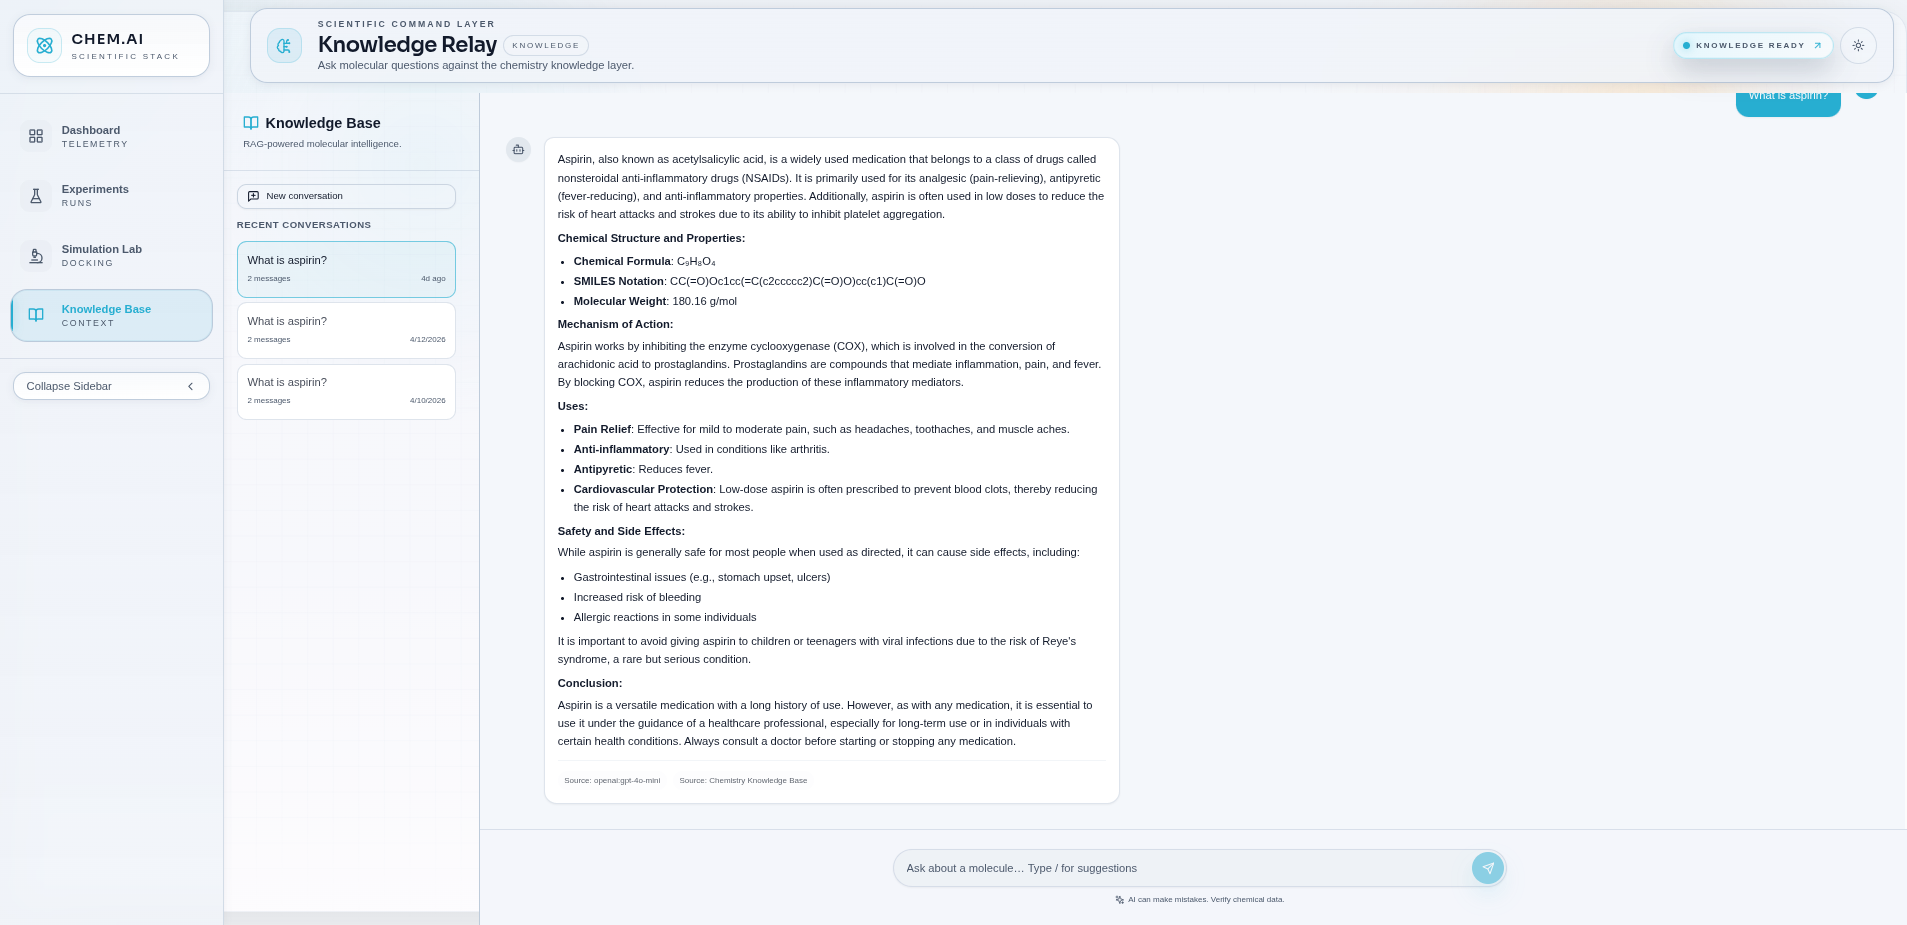
Demo đồ án chạy cục bộ · 1 phút 47 giây. Dashboard, Experiments và Simulation đã hoạt động; RAG/Knowledge vẫn đang phát triển.
Tổng quan
LexiChem biến mô tả phân tử bằng ngôn ngữ tự nhiên thành cấu trúc có thể xem, kiểm tra và khảo sát tiếp. Thay vì dừng ở một bản demo đơn giản, nhóm ba người chúng tôi đã đưa toàn bộ quy trình vào một ứng dụng: nhập yêu cầu, sinh ứng viên, kiểm tra cấu trúc qua RDKit, so sánh kết quả và xem lại lịch sử thử nghiệm.
Tôi tập trung vào pipeline dữ liệu AI, chuyển đổi SMILES/SELFIES, phát triển phương pháp, chạy ablation và tối ưu đường suy luận nối mô hình với backend. Giao diện và các luồng chức năng khác là công việc chung của cả nhóm.
Cách hoạt động
01Mô tả
02Suy luận mô hình
03Cấu trúc phân tử
04Khám phá 2D / 3D
LexiChem đảm nhiệm phần sinh cấu trúc và khảo sát trên máy tính. Tổng hợp và thử nghiệm trong phòng lab là chặng tiếp theo, nằm ngoài ứng dụng. Bấm vào ảnh để xem lớn.
Từ nghiên cứu đến sản phẩm
Ứng dụng có bốn khu vực: Dashboard, Experiments, Simulation và Knowledge. Trong đồ án tốt nghiệp, chúng tôi thực nghiệm với ba bộ dữ liệu Mol-Instructions, L+M-24 và ChEBI-20. Bài báo APWeb-WAIM 2026 đi sâu vào phương pháp cốt lõi: căn chỉnh biểu diễn văn bản và SELFIES trong không gian ẩn dùng chung, được đánh giá trên tập chuẩn L+M-24.
LexiChem hỗ trợ sàng lọc và khảo sát tính toán ban đầu trên máy tính. Hiệu quả sinh học và khả năng tổng hợp thực tế vẫn cần được kiểm chứng trong phòng lab.
Phần tôi trực tiếp làm
Ở nhánh nghiên cứu, tôi phát triển ý tưởng phương pháp rồi kiểm tra qua các thực nghiệm và ablation. Tôi viết phần Introduction, toàn bộ Results & Discussion, và cùng một thành viên khác viết Methods cho báo cáo đồ án.
Với dữ liệu, tôi xử lý Mol-Instructions, L+M-24 và ChEBI-20; dùng RDKit để phân tích cú pháp, kiểm tra hóa trị, chuẩn hóa SMILES và loại bỏ trùng lặp; sau đó chuyển phần dữ liệu hợp lệ sang SELFIES để huấn luyện.
Ở phía kỹ thuật, tôi nối Experiments với backend. Luồng này tiếp nhận prompt, gọi mô hình qua FastAPI và Triton, kiểm tra SMILES trả về bằng RDKit rồi lưu lịch sử chạy vào MongoDB. Các phần còn lại của ứng dụng do cả nhóm cùng phát triển.
Sản phẩm khi chạy thực tế
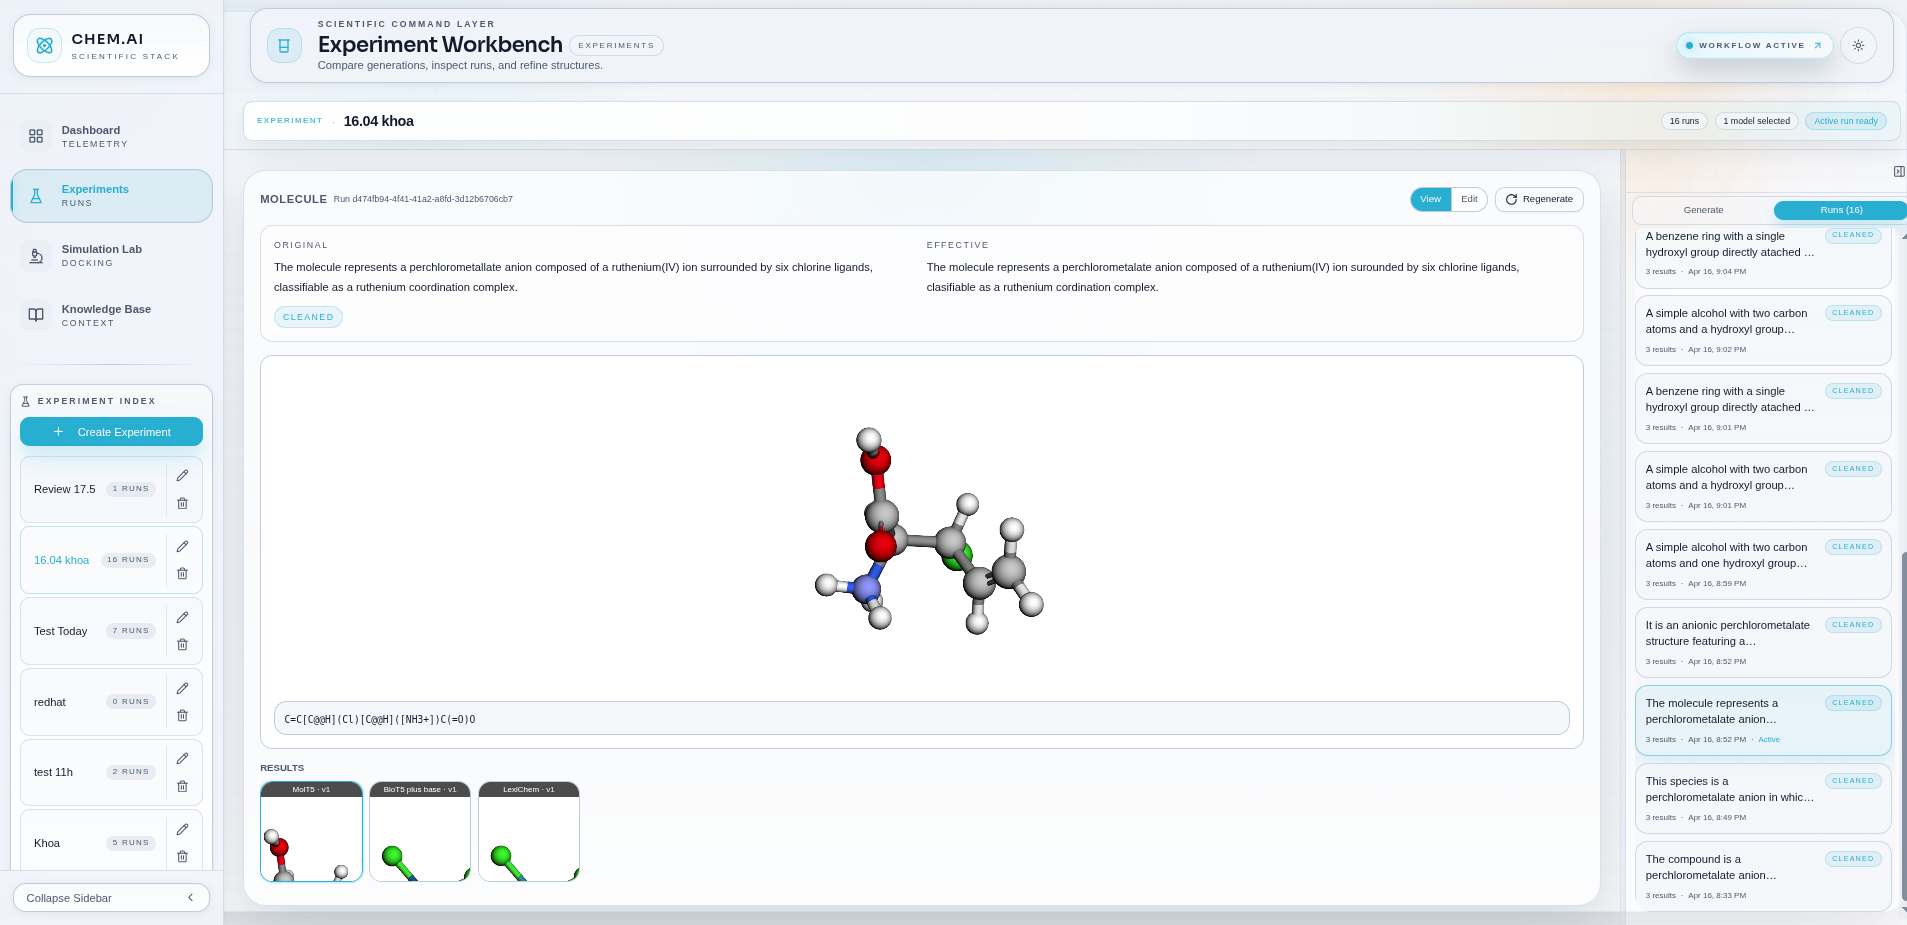
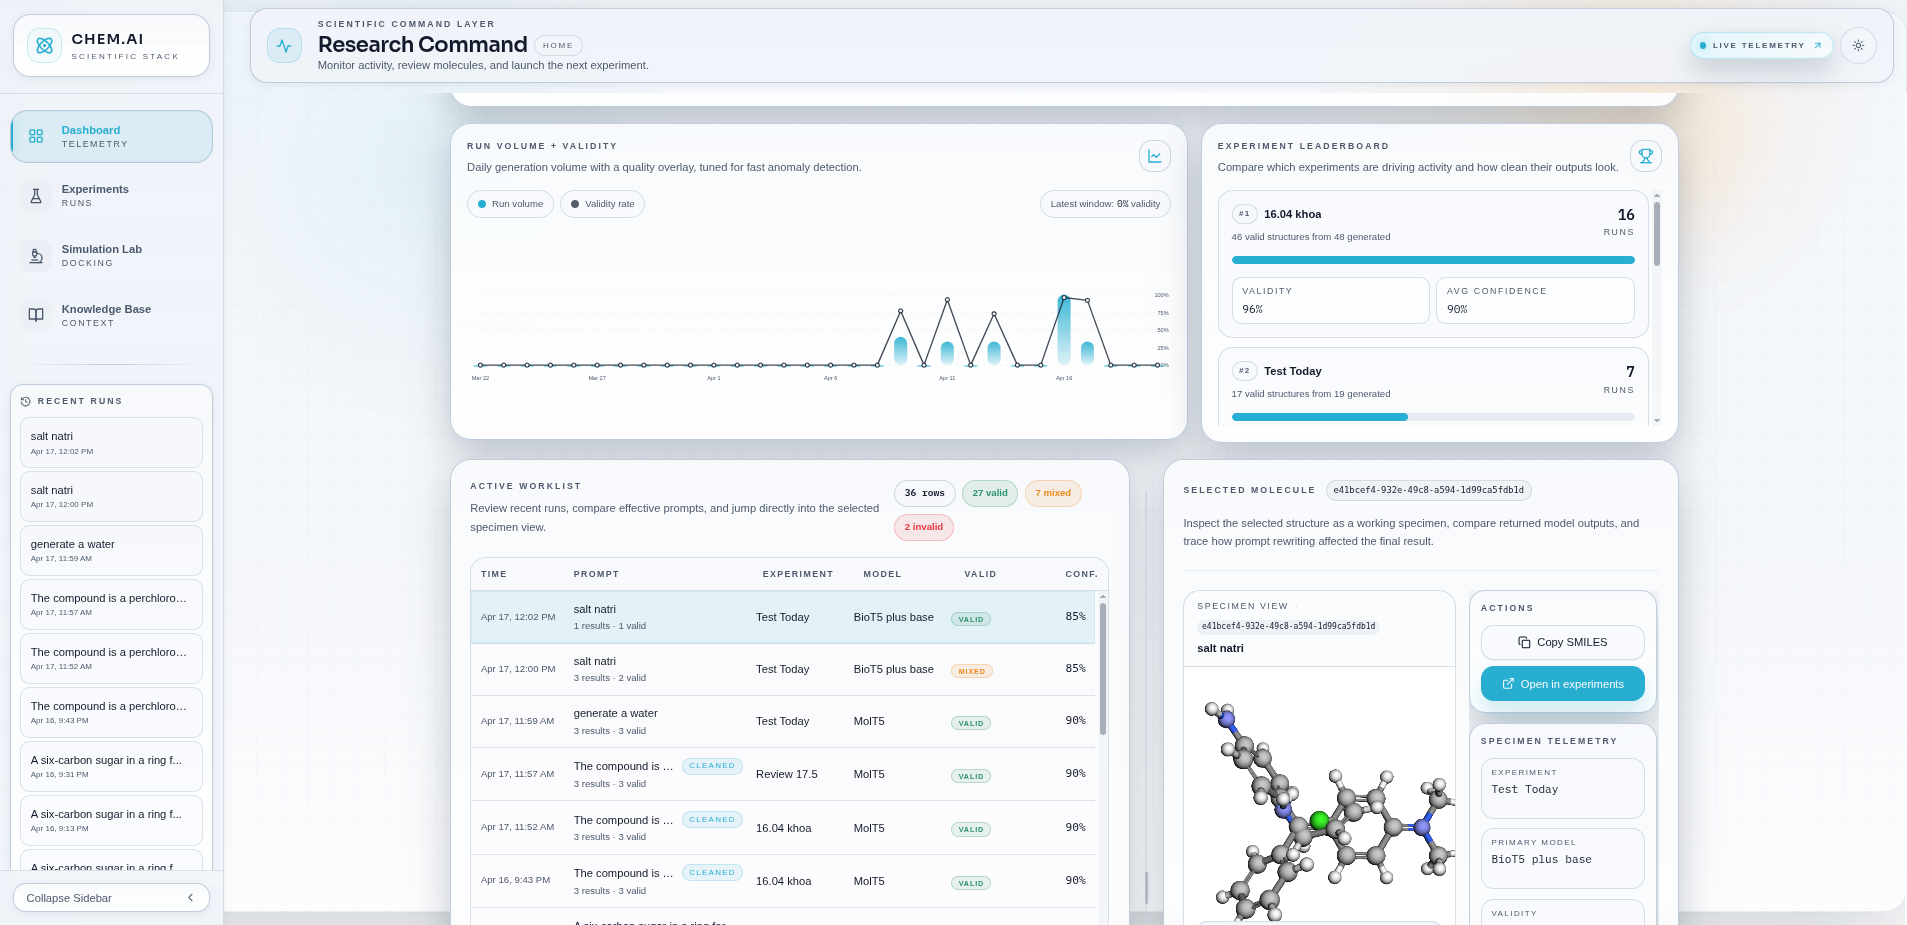
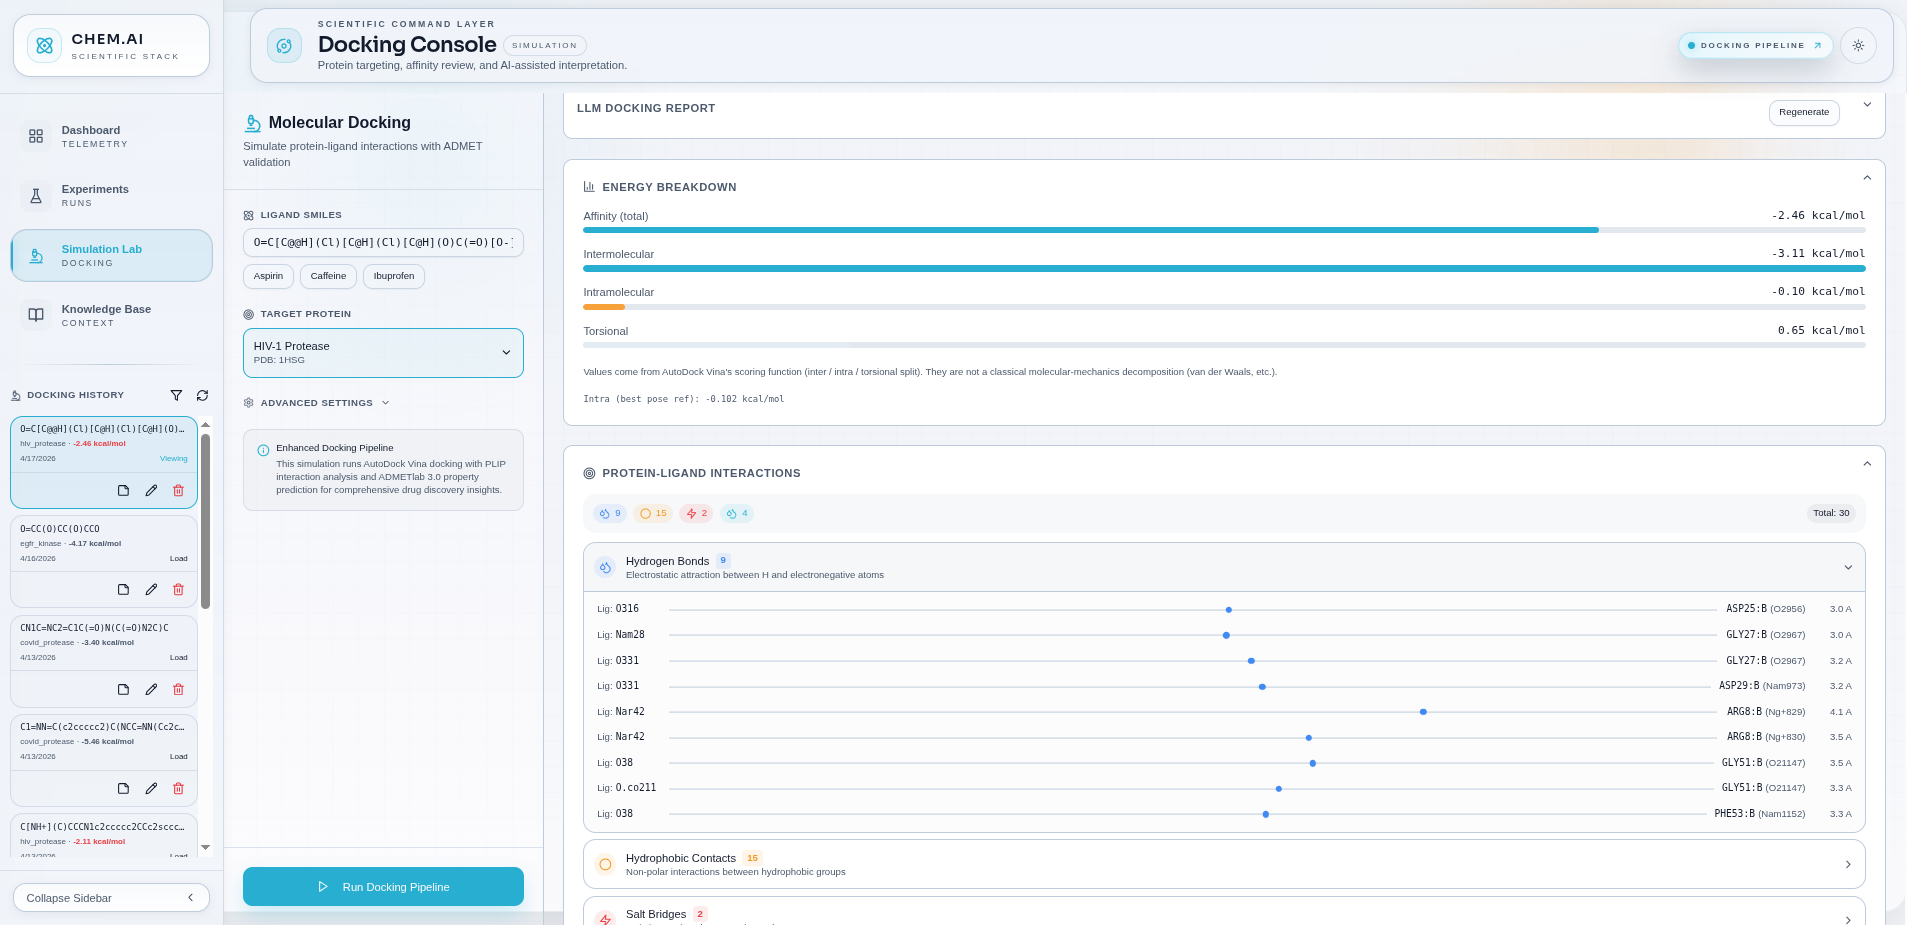
Ảnh và video bên dưới được ghi lại từ phiên bản chạy cục bộ của đồ án. Dashboard, Experiments và Simulation đã hoạt động; RAG/Knowledge vẫn đang phát triển. Các con số xuất hiện trong ảnh là trạng thái của phiên demo, không phải kết quả benchmark độc lập.
Experiments Workbench · so sánh prompt và kết quả giữa nhiều model.Dashboard · theo dõi lịch sử chạy và phân tử đang chọn.Simulation · khảo sát ligand, protein đích và các tương tác.Knowledge · giao diện cho phần RAG/Knowledge đang phát triển.
Kết nối nghiên cứu
Hội nghịAPWeb-WAIM · 2026Đã chấp nhận
LexiChem: Shared-Latent Alignment for Faithful Text-to-Molecule Generation in SELFIES Space
Khoa Minh Nguyen, Nam Van Hai Phan, Phu Trong Nguyen, Duc Tai Phan, Tri Minh Pham, Duc Ngoc Minh Dang
APWeb-WAIM Joint International Conference on Web and Big Data
Tác giả chính
Căn chỉnh không gian ẩn chung giữa văn bản và SELFIES cho bài toán sinh phân tử, đánh giá trên tập L+M-24 từ nghiên cứu trọng tâm của đồ án tốt nghiệp.
@inproceedings{lexichem2026,
  title = {LexiChem: Shared-Latent Alignment for Faithful Text-to-Molecule Generation in SELFIES Space},
  author = {Khoa Minh Nguyen and Nam Van Hai Phan and Phu Trong Nguyen and Duc Tai Phan and Tri Minh Pham and Duc Ngoc Minh Dang},
  booktitle = {APWeb-WAIM Joint International Conference on Web and Big Data},
  year = {2026},
  note = {Accepted; final publication metadata pending}
}
Nam Van Hai Phan, Khoa Minh Nguyen, Ngoc Thien Phu Nguyen, Nguyen Doan Hieu Nguyen, Tri Minh Pham, Duc Ngoc Minh Dang
International Conference on Computational Intelligence in Engineering Science
Đồng tác giả chính
Căn chỉnh tương phản giữa biểu diễn văn bản và phân tử trên nền BioT5+, đạt 69,77% BLEU và 31,28% khoảng cách Levenshtein trên tập chuẩn L+M-24 (theo số liệu bài báo).
We introduce ChemAligner-T5, a BioT5+ base model enhanced with a contrastive learning mechanism to directly align textual and molecular representations.
@inproceedings{chemalignert52026,
  title = {ChemAligner-T5: A Unified Text-to-Molecule Model via Representation Alignment},
  author = {Nam Van Hai Phan and Khoa Minh Nguyen and Ngoc Thien Phu Nguyen and Nguyen Doan Hieu Nguyen and Tri Minh Pham and Duc Ngoc Minh Dang},
  booktitle = {International Conference on Computational Intelligence in Engineering Science},
  year = {2026},
  doi = {10.1007/978-3-032-21625-0_16}
}